看清结构 · 理顺关系 · 赋能工具 —— 让企业数智化转型真正落地,而不是买了一堆系统却在原地打转。
症状各不相同,但根子是同一个 —— 业务结构没有理清。
周一例会上的尴尬时刻:
销售说签了 1.2 亿,财务说只收到 0.9 亿,运营说回款才 1.0 亿。三个总监互相瞪眼,最后谁也说服不了谁,决策只能搁置。
CRM、ERP、财务、OA 各管一段,一个业务进 5 个系统,数据填 3 遍。数据各说各话,AI 只能猜,人也不敢信。
数智化转型不是 IT 项目,是组织变革。服务商走完了四个阶段,企业却原地踏步:
买了大模型,烧了 Token;PPT 演示很漂亮,真正用到业务里…… AI 答非所问,鸡同鸭讲。
「活跃客户有多少?」—— 三个系统三个答案。AI 能访问您的数据,但不知道这些数据代表什么意思。
大炮打蚊子、拿锤子找钉子、投产比算不清。
您一直在治「标」(影子),从没治「本」(实体)。
数据是车,结构是路。路没修好,给您一辆法拉利,也只能陷在泥里。
帮老板和高管把战略、交易、组织关系透视清楚,让业务结构不再是一笔糊涂账。
让客户、订单、回款的定义在各部门只长一个样,语义统一,数据从源头对得上。
再上系统(或者优化系统)、上 AI,水到渠成 —— 把能力留在企业内部。
让所有人说同一种语言。系统化培训,帮老板、高管、员工统一对数智化转型的认知和理念。上下同频,转型才能起步。
澄清人、系统、AI 的边界和投产比,让转型从共识开始,而不是从分歧开始。
从「人找数据」到「数据找人」。深度走进企业,统一数据语义,设计业财融合方案。
统一语义、业财融合方案设计、让 AI 读懂您的业务 —— 把业务对象、流程、规则全部定义清楚。
大处规划,小点切入。按优先级先选最痛的场景落地,跑通再扩展。能力留在企业内部,项目撤了人还在。
系统选型 + 实施监理 + AI 模型评估 —— 帮您选对的,不选贵的。
经评估后承接的项目(做不到的我们一开始就不接)
2016 年成立,近亿元投入,只做一件事
统一语言、逐层建模、语义驱动行动
从数据定义到业务建模到智能核算
我们独立走到了同一条路上:统一语言、逐层建模、语义驱动行动。
按行业精选,均为经评估后落地、拿到真实回报的项目 —— 多家国家级专精特新企业,每年为客户节省数百万成本。
| 行业 | 客户名称 | 项目概述 | 项目效果 |
|---|---|---|---|
| 服务业 | 智联招聘 | 从回款匹配自动化项目开始,迭代到基于回款的绩效考核与分配自动化、智能化,最终升级为智联招聘集团的收入数据中台项目,成为 CEO 级别项目,是整个集团处理和分发收入数据、绩效考核数据的核心平台。 | 应收部门从 21 人处理每月 30 万笔回款匹配,缩减到 2 人处理异常,省 19 人,每年节省 200 万元。 |
| 服务业 | 51talk | 解决企业服务事业部从线索到回款的全生命周期数智化转型,从纯手工记录到客户全生命周期数智化管理,实现决策在线、统揽业务全局和业财融合。 | 节省 6 个数据搬运人员,提高沟通与协同效率,每年节省 100 万元。 |
| 服务业 | 大成律所 | 以大成昆明所项目为标杆,打造律所行业数智化管理版本,解决律师管理、案件管理、工时管理、绩效管理、业财融合等普遍问题,深度解决律师与律所合作效率与资源优化配置、案件风险流程管理问题。 | 节省对账与绩效分配时间,降低沟通成本、律师助理与财务人数,每年为昆明所节省 80 万元。 |
| 行业 | 客户名称 | 级别 | 客户案例概述与效果 |
|---|---|---|---|
| 智能制造 | 博益气动 | 国家级专精特新 | 1. 从设计到搭建客户全生命周期管理平台(CLM),替换原有用友 CRM;2. 搭建供应商全生命周期管理平台(SLM);3. 搭建业财融合中台,并与用友 U9、PLM、MES 系统对接。收益:每年节约 160 万元。 |
| 智能制造 | 凌科电气 | 国家级专精特新 | 1. 从国际化、资本化、数智化三个方向提供咨询与规划数智化解决方案和业财融合方案;2. 解决多 ERP 系统融合问题(跨境电商 ERP 与传统 ERP)。收益:每年节省约 80 万元。 |
| 智能制造 | 祥锦车行 | 国家级专精特新 | 1. 柔性制造的 CPQ 与 CRM 融合;2. 生产质控系统(实时预警与协同),提升电动自行车良品率;3. 业财融合中台,连接 CRM、PLM、MES 和 ERP 系统;4. 跨境报关与物流追踪系统,提高交易效率与出口退税效率。收益:每年节省约 120 万元。 |
| 智能制造 | 好年璟 | 国家级专精特新 | 1. 客户全生命周期管理平台(CLM);2. 供应商全生命周期管理平台(SLM);3. 员工全生命周期管理平台(HLM);4. 业财融合中台,与用友 U8、PLM、MES 系统对接。收益:每年节约 130 万元。 |
en+数智化赋能的 CRA 项目完美融合银企对账系统和业绩追踪系统,把会计的账务处理和财务的业绩核算融合在一起,准确地帮助到财务和业务,也避免了财务和业务之间大量无效的沟通。过程中可以看到 en+ 系统灵活的部署能力和柔性管理理念,这些都对我们帮助非常大。没有 en+数智化,业绩考核就是空谈!
en+数智化让经营数据实时透明、管控自动执行,制度真正从墙上落到流程里,决策效率和管理确定性大幅提升。更重要的是,它构建了完整可追溯的数据链条,为上市审计提供了可信赖的底层支撑,极大缩短了中介机构验证时间,显著降低了合规准备的人力与成本负担。
敢说「不适合」,反而让适合的客户更信任我们。
加拿大注册会计师(CGA)、加拿大苏立克商学院(Schulich School of Business)MBA、西南财经大学会计系本科。
曾任百度移动游戏 CFO,27 年财务和企业管理经验。专注业财融合和企业数智化转型实战 12 年。中国企业财务管理协会特聘数智化转型智库专家、中国 CFO 发展中心数智化特聘专家、企业价值研究院特聘数智化转型专家、数海通慧首席数智化转型专家。
著作:《共享思维:数字化时代的财务管理》《AI 时代下财务发展方向》
从媒体、招聘、通信、法律到智能制造,多个行业的领军企业选择与 en+ 数智化同行。
把方法论讲成老板和财务负责人都听得懂的话。按发布时间倒序,最新的在最前面。
洞察 · 业财融合
曾亮 · en+ 数智化 创始人 · 2026-11-07 · 全文 3068 字,建议留 10 分钟
钱花了,系统上线了,报表更快,纪要也能自动生成。可一到要不要给这个客户放宽账期、这一单接不接,还是几个人在会议室里凭经验拍。
一把手最常问:AI 该用来替代重复劳动提效,还是介入不确定性决策?这个问法本身就是弯路的起点——它把两类目标塞进同一个「上不上 AI」的决策框。
更常见的是把 AI 当万能工具,跳过顶层设计直接选型。本文立场:两类目标的差异不在技术难度,而在价值如何被结算、责任由谁承载。一把手要拍的不是模型,是边界怎么划、螺旋怎么转。
第一类,替代规则明确、可度量的确定性重复劳动,目标是提效。第二类,介入信息不全、变量多、跨环节耦合的不确定性决策或复杂业务链路。
两轴判断比二分法更实用:输出能不能被快速校验——可验证性,说白了就是做完能不能立刻判对错;错了兜不兜得住——后果可逆性,是单点能拦住还是沿链条扩散。
| 可验证性 | 后果可逆性 | AI 的位置 |
|---|---|---|
| 高 | 高 | 给答案,可审计、可追溯 |
| 低 | 低 | 只给选项,人保留最终判断 |
| 低 | 不可逆 | 先别碰 |
确定性指验证标准确定,不是任务没有认知难度。公开案例中,哈尔斯的采购 AI 并未替代战略采购,它接管的是「定时跟踪钢材价格、按规则推送建议」这个可审计环节;难的是把经验写成规则。Kodiak Gas 的物料补货代理把事务处理从 15—20 分钟压到 2—3 分钟,效率提升约 87%,释放 43 个全职人力回现场。共同点:输出可快速校验,错误可单点拦截,所以是 ROI(这笔账算不算得清)最可复现的起点。
两张账本的差异,才真正决定项目命运:
| 维度 | 确定性提效 | 不确定性决策 |
|---|---|---|
| 价值可见性 | 当月、局部、成本项改善 | 滞后、系统级,常表现为「没出事」 |
| 结果可归因 | 归因链短,可做前后对照 | 反事实不可观测,采纳带偏差 |
| 责任边界 | 仍归原岗位,AI 是工具 | 判断权让渡,归责单元缺失 |
| 主要卡点 | 流程、接口、使用习惯 | 决策权归属与考核口径 |
归因链,说白了就是功劳算谁的;反事实不可观测,指没被采纳的那条路永远看不到。前两行决定老板会不会继续投钱,后两行决定项目能不能活下来。用同一套尺子验收两类目标,是所有弯路的起点。
不确定性场景为什么难?先看 AI 推理能力的两面。
优势在通用侧:它理解人类通识与行业知识,能把经验、约束与备选路径快速组织成可讨论的选项。有观察指出,单个模型对战略决策的评估可能不一致且有偏,跨提示、角色、模型聚合后的「群体判断」可接近专家水平——它更适合做观点生成与压力测试装置。
劣势在现场侧:它缺乏对具体企业业务与场景的理解。你家的客户算几个、什么算「已回款」、那条例外当年为什么开、谁有权改口径,都不写在公开语料里,模型只能猜。
所以不确定性里很大一块,不是外部世界太乱,而是企业自己的说法没被写下来。这是可治理的不确定,不是固有的不确定。
en+ 数智化 一直讲:业财融合才是中国企业的本体论。 说白了,是给全公司定一本都认的「词典」,让同一个词只有一个定义、一个口径、一个责任人。AI 只能在这层普通话之上工作。 可验证的自检:让销售、财务、运营各写一遍「已回款」的定义;三份不一样,该补的不是模型,是那本词典。
顺序由此确定。en+ 数智化 的判断是:方案是灵魂,工具是载体;先有词典,再有平台,先有方案,再有工具。 顶层设计不是前期的一叠文档,它本身就是第一轮要沉淀的资产。一把手最该投入时间的是这件事,不是选型。
边界也要说清:市场变化、对手动作、人的意图永远收敛不了,那部分就「给选项、人拍板」。把两类不确定混为一谈,要么过度治理,要么过早放弃。
不确定性不是靠更强的模型解决的,而是靠「沉淀 → 优化 → 执行 → 再沉淀」,一圈圈把可验证性生产出来。
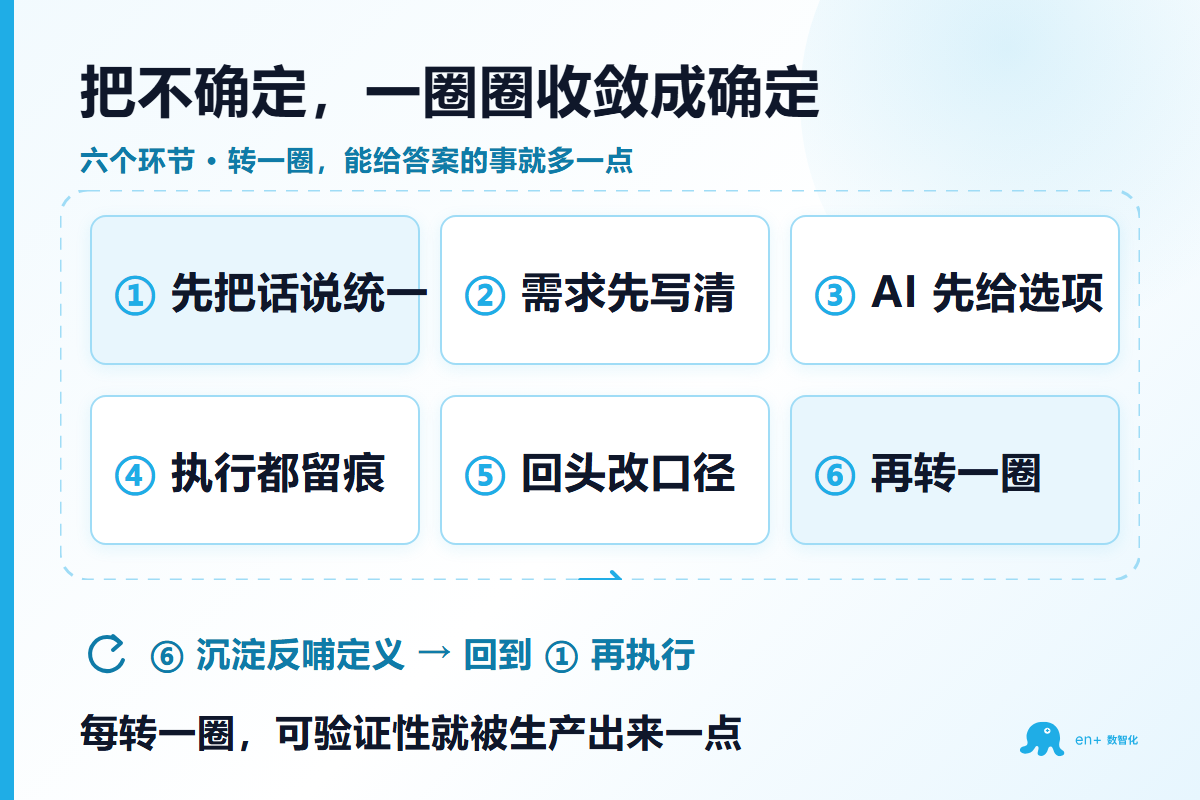
① 顶层设计:本体与语义定义,先把话说统一。
② 落地切入点:需求结构化与能力匹配。先写清要什么、按什么口径验收,再看供应商能力对不对得上。
③ 落地载体:AI 辅助执行。先给选项、可校验,输出留审计轨迹。
④ 数据沉淀:每次执行、建议是否被采纳、结果如何,都留成企业自己的记录。
⑤ 反哺定义:用沉淀回来的事实,回头修订口径、规则与例外。
⑥ 再执行:下一圈,「能给答案」的边界向外挪一格。
每转一圈,可验证性是被生产出来的,不是天生缺失的。 这正面回答了「不确定性场景是否天然更难产生可验证价值」:难的是没启动螺旋,不是场景本身。
螺旋也解释了依赖关系错配:最快能证明价值的确定性场景,不会自动沉淀所需的定义、基线与责任共识。只挑最容易省人的环节,转一圈还在原地;把每个确定性项目当成第一圈来做,它才成为入场券。
对照材料的三层分级,可理解为螺旋的阶段:确定性流程做主干、AI 做增强;不确定性场景 AI 辅助、人保留判断;少数规则随情境变化的业务,才用概率性系统的逻辑重构流程与组织。第三层不是「走到就成熟」,它需要另一种治理能力。有观察指出,仅约两成 AI 项目达成预期,「范围界定不当」是主因之一;建立「试点未转入运营即关停」标准的组织,跻身领先组的概率高出约 2.3 倍。跳过前两层直追自主决策,是最贵的弯路。
不确定性场景阻力更大,且性质发生跃迁。确定性场景的阻力在流程内,项目管理可解;不确定性场景的阻力在结构里,项目管理无权处理。
公开案例中,Salesforce 裁撤约 4000 名客服、让 AI 接管后遭遇困境。表面是模型在长尾需求、多轮升级场景中表现不佳;更根本的是,在没有界定「AI 拥有哪些决策权、在什么条件下、容忍多大不确定性」之前,就把人类判断从回路中整体移除。供应链 AI 试点的失败指向同一诊断:项目启动了,却没定义代理能决定什么。失败的核心不是模型精度,而是决策设计缺位——这是组织决策问题。
阻力分四层:① 技术与数据层,信息不全、口径不一,多数是语义治理欠账的投影;② 流程与考核层,指标按岗位切分、改善却跨环节,收益记在 A 部门、成本落在 B 部门;③ 权责与决策权层(主阻力),引入系统建议后,采纳或没采纳出事各算谁的,制度里没有位置,于是规定「仅供参考、最终由人决定」却不写进流程,AI 被放在既无权、也不担责、也不被记录的位置——永远在试点;④ 认知与合法性层,判断依据从经验转向「模型输出 + 经验」,资深人员经验资本贬值,最不显性却决定前三层能否推动。
另有两条隐蔽弯路。其一,用确定性尺子量不确定性目标:要求当月、单环节、精确到百分比的收益,团队只能把目标收缩成易度量的局部指标;本来想让 AI 帮着拍板,最后交出一堆自动报表——上线成功,价值落空。其二,先做容易的事会锁死组织想象力:第一次让 AI 干省人省钱的活,全公司从此只认它是降本工具,往后涉及判断权的项目都被按降本口径卡住。
处方一句:人拍板 + 建议与采纳留痕 + 事前约定「什么叫改善」。前一句防风险,后两句才让价值可被结算。
螺旋不会自己转。它需要的不是更强的模型,是能把定义写下来、把口径谈拢、把责任落到位的人。
这回到一把手最容易忽略的顶层设计与规划:本体、语义与数据定义属于方案层,平台与模型属于工具层。工具可以采购,方案不能外包给供应商;把这件事下放,等于把决策权设计交给卖工具的人。
内部,要培养既懂业务语义、又懂数据与技术的跨界人才。en+ 数智化 讲,财务 BP 与业务骨干是「企业词典的现场编写者」——不是转行,是归位;被替代的不是财务,是搬运。
外部,需要专家 FDE 陪跑:带方法进现场、与甲方共创、能力交接后退出。en+ 数智化 有一条硬判断:陪跑不是代跑,没有退出条件的陪跑,本质上就是长期驻场。 落点是交付词典、口径、规则等语义资产,而非报表看板;甲方能独立跑完一轮,退出条件前置写进方案。否则项目结束之日,就是能力归零之时。
批预算时多问一句:这一轮结束,留在公司里的是一套系统,还是一支能自己修订词典、把螺旋转下去的队伍?
① 输出能不能快速校验?错了兜不兜得住?
② 这次是给答案、给选项,还是先别碰?谁签字、按什么口径认账?
③ 有没有那本统一的词典?顶层设计做在选型之前了吗?
④ 建议采纳与结果留痕了吗?沉淀反哺回定义了吗?
⑤ 项目结束,留下的是系统,还是能自己转螺旋的人?
AI 落地的分水岭,从来不是模型够不够强。是老板肯不肯先把两类目标分清、把顶层设计做扎实,把「谁说了算、出了事算谁的、按什么认账」讲清楚。前一个是技术问题,后一个是权责边界问题与组织能力问题。
一把手在这个地方省下的那半小时,后面往往要用一年补。
en+ 数智化|让企业数智化转型少走弯路
企业数智化 · 健康体检:3 分钟定位数智化成熟度、数据质量与语义质量短板,survey.enfry.com
关于作者
曾亮 · en+数智化 创始人
加拿大注册会计师(CGA)、Schulich 商学院 MBA,27 年财务与数智化从业经验。主张以业财融合为抓手做数据治理,反对长期驻场外包,坚持把能力留在甲方。
想聊聊你们公司的业财融合怎么起步?
加微信,说清楚你现在的痛点,我们先做一次免费的现状诊断。
微信 / 电话:138 1154 6176 · zengliang@enfry.com
11 月 2 日,Palantir 交出一份营收同比暴涨 96% 的财报。
同一场电话会上,CEO Alex Karp 却把枪口对准了整个 AI 行业。
一边数钱,一边开骂。他到底在骂谁?更重要的是——他无意中暴露了中国企业做 AI 最容易踩的那个坑。
2026 年第三季度,Palantir 的财报几乎挑不出毛病。
营收 23.13 亿美元,同比增长 96%,环比增长 20%。净利润 11.28 亿美元。全年营收预期上调到约 85.3 亿美元。
更值得看的是收入结构的变化。
美国商业业务营收 9.84 亿美元,同比增长 148%,第一次超过同期 9.53 亿美元的美国政府业务。
过去 Palantir 靠政府和国防吃饭,现在商业客户成了增长主引擎。这个转折比 96% 本身更有信息量:说明企业市场真的在掏钱。
然后,就在同一场电话会上,Karp 开始骂人。
他骂的不是竞争对手,是整个行业的商业模式——靠转卖 Token、靠 API 调用量、靠名不副实的“部署规模”撑增长。他的意思是,客户已经厌倦了这些证明不了实际效果的东西。
一家公司营收翻倍的时候,CEO 反过来质疑自己所在行业的增长方式。这个反差,是今年企业 AI 最值得读的一条新闻。
因为他说的是实话。
模型被调用了多少次,和这家企业多赚了多少钱,中间隔着一整个太平洋。
一个 Agent 一天处理几万次请求,可能只是让员工把原来要干的活干得更快。但如果采购审批仍然要走五天,库存积压照样降不下来,客诉还是没人闭环——调用量再大,也变不成经营效率。
它怎么把“用了 AI”变成“赚了钱”?原文给了三层。我用更直白的话重说一遍。
第一层:本体论(Ontology)——给公司建一本词典。
ERP 里有订单,CRM 里有客户,生产系统里有工单,财务系统里有预算。这些系统各自记各自的账,说法都不一样。
Ontology 干的事,是把这些数据重新组织成有业务含义的对象——订单、客户、设备、供应商——再用关系把它们连起来。
AI 去查一张订单,能顺着关系找到库存、供应商、生产计划,知道这件事牵动什么、影响谁。
第二层:工作流——AI 要进流程,不是进工位。
Palantir 的 CTO Shyam Sankar 说了一句很狠的话:企业的基本单元不是知识工作者,是工作流。
这句话戳的是这几年企业上 AI 的通病——给每个岗位发一个 AI 助手。
销售用 AI 写邮件,财务用 AI 看报表,采购用 AI 整理供应商资料。每个人都快了一点,但整条流程一点没变快。
因为企业的事,从来不是一个人干完的。一张订单从签订到回款,要经过报价、审批、发货、开票、对账、催收。AI 只在其中一个环节快了十分钟,剩下六个环节还在人肉搬,总周期几乎不动。
第三层:后训练——让企业自己的业务长出模型。
这是最容易被忽略、也最有意思的一层。
Palantir 的说法是,很多有经济价值的企业任务,根本不需要最强的模型。业务范围清楚、评价标准稳定的活,用企业自己的数据微调一个小模型,效果更好、成本更低。
它举了三个例子。
L3Harris 整合了 30 多个 ERP 系统,用自身业务数据微调开放模型。不到 48 小时,在特定任务上超过了此前用的前沿模型,成本降低 95%。这是厂商披露的初步测试,比较范围仅限具体业务任务,不代表小模型在通用能力上超过大模型。
建筑企业 McCarthy 用 10 万多条真实项目的 RFI(信息请求)做微调,喂给一个 4B 的小模型。这个模型负责识别工程风险、起草合同条款。按厂商预期,每年可省约 3 万小时。
NVIDIA 用类似方法优化供应链任务,单块 GPU 几小时就能完成一轮训练。
三层串起来是一条闭环。
业务执行产生数据和反馈,本体论把这些状态组织起来。数据进入后训练,新模型回到工作流,新反馈再检验。
模型不再靠“等下一个版本”,而是靠企业自己的业务长出能力。
技术讲得再好,也要看客户愿不愿意续费。财报里的事实是:愿意。
一家全球家电企业,第二季度启动 100 万美元的 AI 试点。同季度扩展到年合同 300 万美元。第三季度增加到 1500 万美元,覆盖商业、财务和供应链工作流。
另一家工业材料企业,从接近 300 万美元的试点,扩展到 2900 万美元年合同。
净美元留存率 165%。第三季度完成 212 笔百万美元以上的交易,其中 64 笔超过 1000 万美元。
这个数字很关键:客户不是买一次试试,是越用越多。
越用越多的前提只有一个——它真的解决了问题。从一条工作流开始,验证有效,再用同一套业务对象和执行机制扩到别的部门。不用每个场景重建一次系统,边际成本才会降下来。
如果故事到这里结束,这就是一篇标准的“Palantir 封神”稿。
问题是,财报里还有一组数字,很少被人拿出来讲。
第三季度,总新签合同价值 29.18 亿美元,同比增长 6%。美国商业业务新签合同 14.63 亿美元,同比增长 11%。
而上一季度,这个数字的同比增速是 153%。
营收涨 96%,新签合同的增速从 153% 掉到 11%。
存量客户还在加钱,但新客户、新场景的扩张速度,明显慢下来了。
这个落差说明什么?
高基数、宏观预算周期、竞争对手增多,都可能是原因。单一数据不足以下结论。
但 11 月 2 日那场电话会,Karp 自己给了一个更直接的答案。
被问到训练营(bootcamps)的效果时,他说从首次接触到做出试点或投产,时间线“完全改变了”。紧接着这一句是关键:
What we have to do internally is figure out how to re-resource our company to focus exclusively on those people, because we don't have even the bandwidth to do that.
意思是:公司内部要重新调配资源,专注到这批人身上——因为连这点带宽,我们都没有。
谈到那些还没被说服的 CEO,他又补了一句:
We really cannot satiate demand.
我们真的满足不了需求。
一家营收同比涨 96% 的公司,公开说自己缺的不是订单,是人。有长期跟踪 FDE 组织的研究者把这句总结得更狠:发明了前置工程师这个岗位的公司,说自己没人了。
线索到这里就接上了。
卡点不在技术,在人。
这套模式的扩张,不是装个软件就完事。
每进一个新客户、每扩一个新场景,都要有人把这家企业的业务,一句一句翻译成 Object、Property、Link。
订单到底是什么?毛利怎么算?这个字段归谁改?这笔异常算不算异常?
这个活,Palantir 有一个专门的岗位来干:FDE,Forward Deployed Engineer,前置部署工程师。
人直接进客户现场,跟业务坐在一起,把说不清的业务规则变成系统读得懂的语义。
Palantir 最不像软件公司的地方就在这里。它卖的不是 License,是“人 + 语义”。
而这门生意有个天然的天花板——FDE 是长出来的,不是招进来的。
一个人要同时懂客户业务、懂数据建模,还得能在会议室里跟业务总监吵出一致口径。这种复合能力,培养周期以年计。
产能不够,结果就会写在市场的取舍上。还是那场电话会,谈到美国以外的市场,尤其是欧洲,Karp 说得更直白:
Palantir is in a unique position where we really don't have the bandwidth to do anything that's difficult outside of America.
一家营收翻倍的公司,说自己没有带宽去做美国以外任何困难的事。
他还提到法国。他认为法国是对这个问题认识最清楚的国家,但解决方案涉及购买美国产品,这让事情变得复杂。
这不是市场判断,是产能判断。哪儿都想去,人不够,只能先做离得最近、最好做的那一块。
所以 96% 的营收增长里,有相当一部分是人的产能在增长。合同签得比人长得快,增速自然会掉下来。
原文自己也承认了两件事:本体论需要持续维护业务对象和规则;复杂企业的历史系统和组织边界,不会因为引入 Agent 就自动消失。
翻译成一句人话:词典要人一笔一笔写出来,而且天天要维护。
这才是这条新闻对中国企业真正的价值。
过去两年,我见过太多企业拿着 Palantir 的架构图开会。讨论的都是:我们是不是也要建一个本体?要不要上知识图谱?选哪家的平台?
很少有人问一句:谁来写这本词典?
于是一个典型的路径就出现了:立项、选型、买平台、搭中台、建了几个模型、半年后没人用。
今年 5 月我写过《从“工具幻觉”到“本体重构”》,讲的就是这个失败循环。一句话概括:企业以为买的是能力,其实买的是一套空语义壳。
壳里没有东西。
因为定义“客户”到底是什么、口径归谁定、异常谁来判,这些事平台一件都干不了。
它们只能由人干。
而这个人,必须同时站在两边的现场:一边知道业务到底怎么跑的,一边知道这个数最后进哪张表、担什么责任。
很多人第一反应是找 IT。
我在 8 月那篇《别再迷信“驻场FDE”了》里已经说过一次:把这件事整包给外部驻场,结果一定是“项目结束之日,能力归零之时”。顾问一撤,口径又开始打架,系统没人敢改。
代跑不是陪跑。这个坑中国企业踩了二十年。
真正的解法,是让企业自己长出 FDE。
具体是三种人。
财务 BP。 他天然同时握有业务现场和财务口径。一笔合同签下来,业务看的是金额,财务看的是收入确认。这两件事必须在他脑子里合成一件事。
我常讲一句话:财务 BP 不是“懂业务的财务”,是企业词典的现场编写者。
HRBP。 人是最难被定义的业务对象。“一个在编员工”“一个外包”“一个实习生”“一个人同时挂在两个项目上”——这些在 HR 系统里可能是四张表,在成本核算里必须是四个不同的人天单价。
谁把这个说清楚?HRBP。
ITBP。 所有语义最后要落到系统里,要有权限,要有状态流转。ITBP 是那个知道“这个改动会震到哪些系统”的人。
三种人合起来,才凑齐一个 FDE 的完整能力。
| 角色 | 带来的语义 | 对应 Ontology 的层 |
|---|---|---|
| 财务 BP | 口径、维度、状态、谁负责 | Data + Logic |
| HRBP | 人的对象定义、人天与成本归属 | Data |
| ITBP | 可执行性、权限、系统边界 | Action + Security |
再往上,才是 AI。
AI 不需要你去教它“什么是订单”。它需要你告诉它“在你们公司,订单的哪个状态才算真正的成交”。
这件事,只有企业自己的人知道。
这是我今天最想说的一句。
绝大多数企业谈 AI,默认的顺序是 AI for Human——让 AI 来服务人。
方向没错,顺序错了。
在 AI 能服务人之前,必须先有人服务于 AI。
我把这个动作叫 Human for AI:在 AI 上岗之前,由人先把三样东西显式地交出去。
一是业务语义。这个词在你们公司到底指什么。
二是判断规则。什么情况算异常,什么情况算正常波动。
三是例外处理。历史上有哪些特殊情况,当时是怎么处理的、谁批的。
这三样交不出去,AI 就永远只能做通用问答。它能写诗、能总结会议、能翻译合同,但做不了你公司的事。
让 AI 更懂企业,是前提,不是结果。
而这个“让它更懂”的动作,本质上是企业做一次自我翻译——把散落在老员工脑子里、Excel 隐藏列里、三次部门会议争吵里的东西,写成一套机器读得懂的定义。
这件事,Palantir 管它叫 Ontology。
我们管它叫业财融合。
思想同源,路径不同。
Palantir 面对的是主数据相对成熟的欧美企业,它可以用一支 FDE 部队现场翻译。中国企业面对的是 ERP 好几套并存、基础编码不统一、业务半年一变,而且真正懂经营语义的人,往往在财务和业务骨干身上,不在 IT 部门。
所以我们不能只买平台,也不能只请顾问。
得把两件事合起来:外部顾问陪着,企业自己的 BP 长出能力,最后顾问退出,能力留下。
这就是“陪跑不是代跑”。我们真正的交付物不是系统,是一支甲方自己的、能独立运转的业财融合队伍。
没有退出条件的陪跑,本质上就是长期驻场。
不用等年报,也不用先买平台。
第一个:你们公司的“客户”,是一个客户吗?
让销售、财务、客服各写一遍定义,看看是不是一回事。如果三套编码三套含义,你的 AI 地基就还是空的。
第二个:随便挑一个指标,比如“毛利率”,能说清它是怎么算出来的吗?
不是公式。是每一层分摊规则、每一个例外处理,谁定的、什么时候定的、为什么这么定。
第三个:一个关键异常发生时,现在是“三个人花两天找数据”,还是“数据自己找到责任人并触发动作”?
这一条,是我们讲的“五个正确”里最难的一条:正确的时间、正确的地点、正确的数据、正确的维度和口径、正确的人。五个缺一个都不成立。
三条里只要有一条答不上来,你缺的不是模型。
缺的是那本词典,和写词典的人。
Palantir 那份财报最扎人的地方,不是 96%。
是它一边证明这条路能走通,一边告诉你:这条路要靠人走。
AI 不会自动懂你的企业。
在它懂之前,得先有人替它把话说清楚。
这件事,买不来,也外包不掉。
资料来源:Palantir 2026 年第三季度财报(11 月 2 日)及同场财报电话会公开记录;后训练相关案例数据来自厂商披露,保留原始限定条件。
周一早上,老板问了一句:“华东区上个季度,项目毛利到底是多少?”
财务说 18%,业务说 23%,运营说 15%。
三个人都没算错——因为他们讲的其实是三件事:
老板要的明明是一个答案,最后变成三个人、两天的会,还没吵完。
数据一条不少,问题出在哪儿?
出在这家公司里,同一个词,有三套说法。
“毛利”这两个字谁都会写。但毛利里算不算分摊?算不算售后?按什么时点确认?——没人说清楚过。
而在大洋彼岸,有一家公司,靠解决这同一个问题,做到了 4500 多亿美元的市值(2026 年 10 月数据,历史最高曾突破 5000 亿美元)。
它给这套“统一的说法”起了个名字,叫本体论(Ontology)。
一句话读懂这篇:
业财融合和 Palantir 的本体论,解决的是同一件事——给企业定一本全公司都认的“词典”。
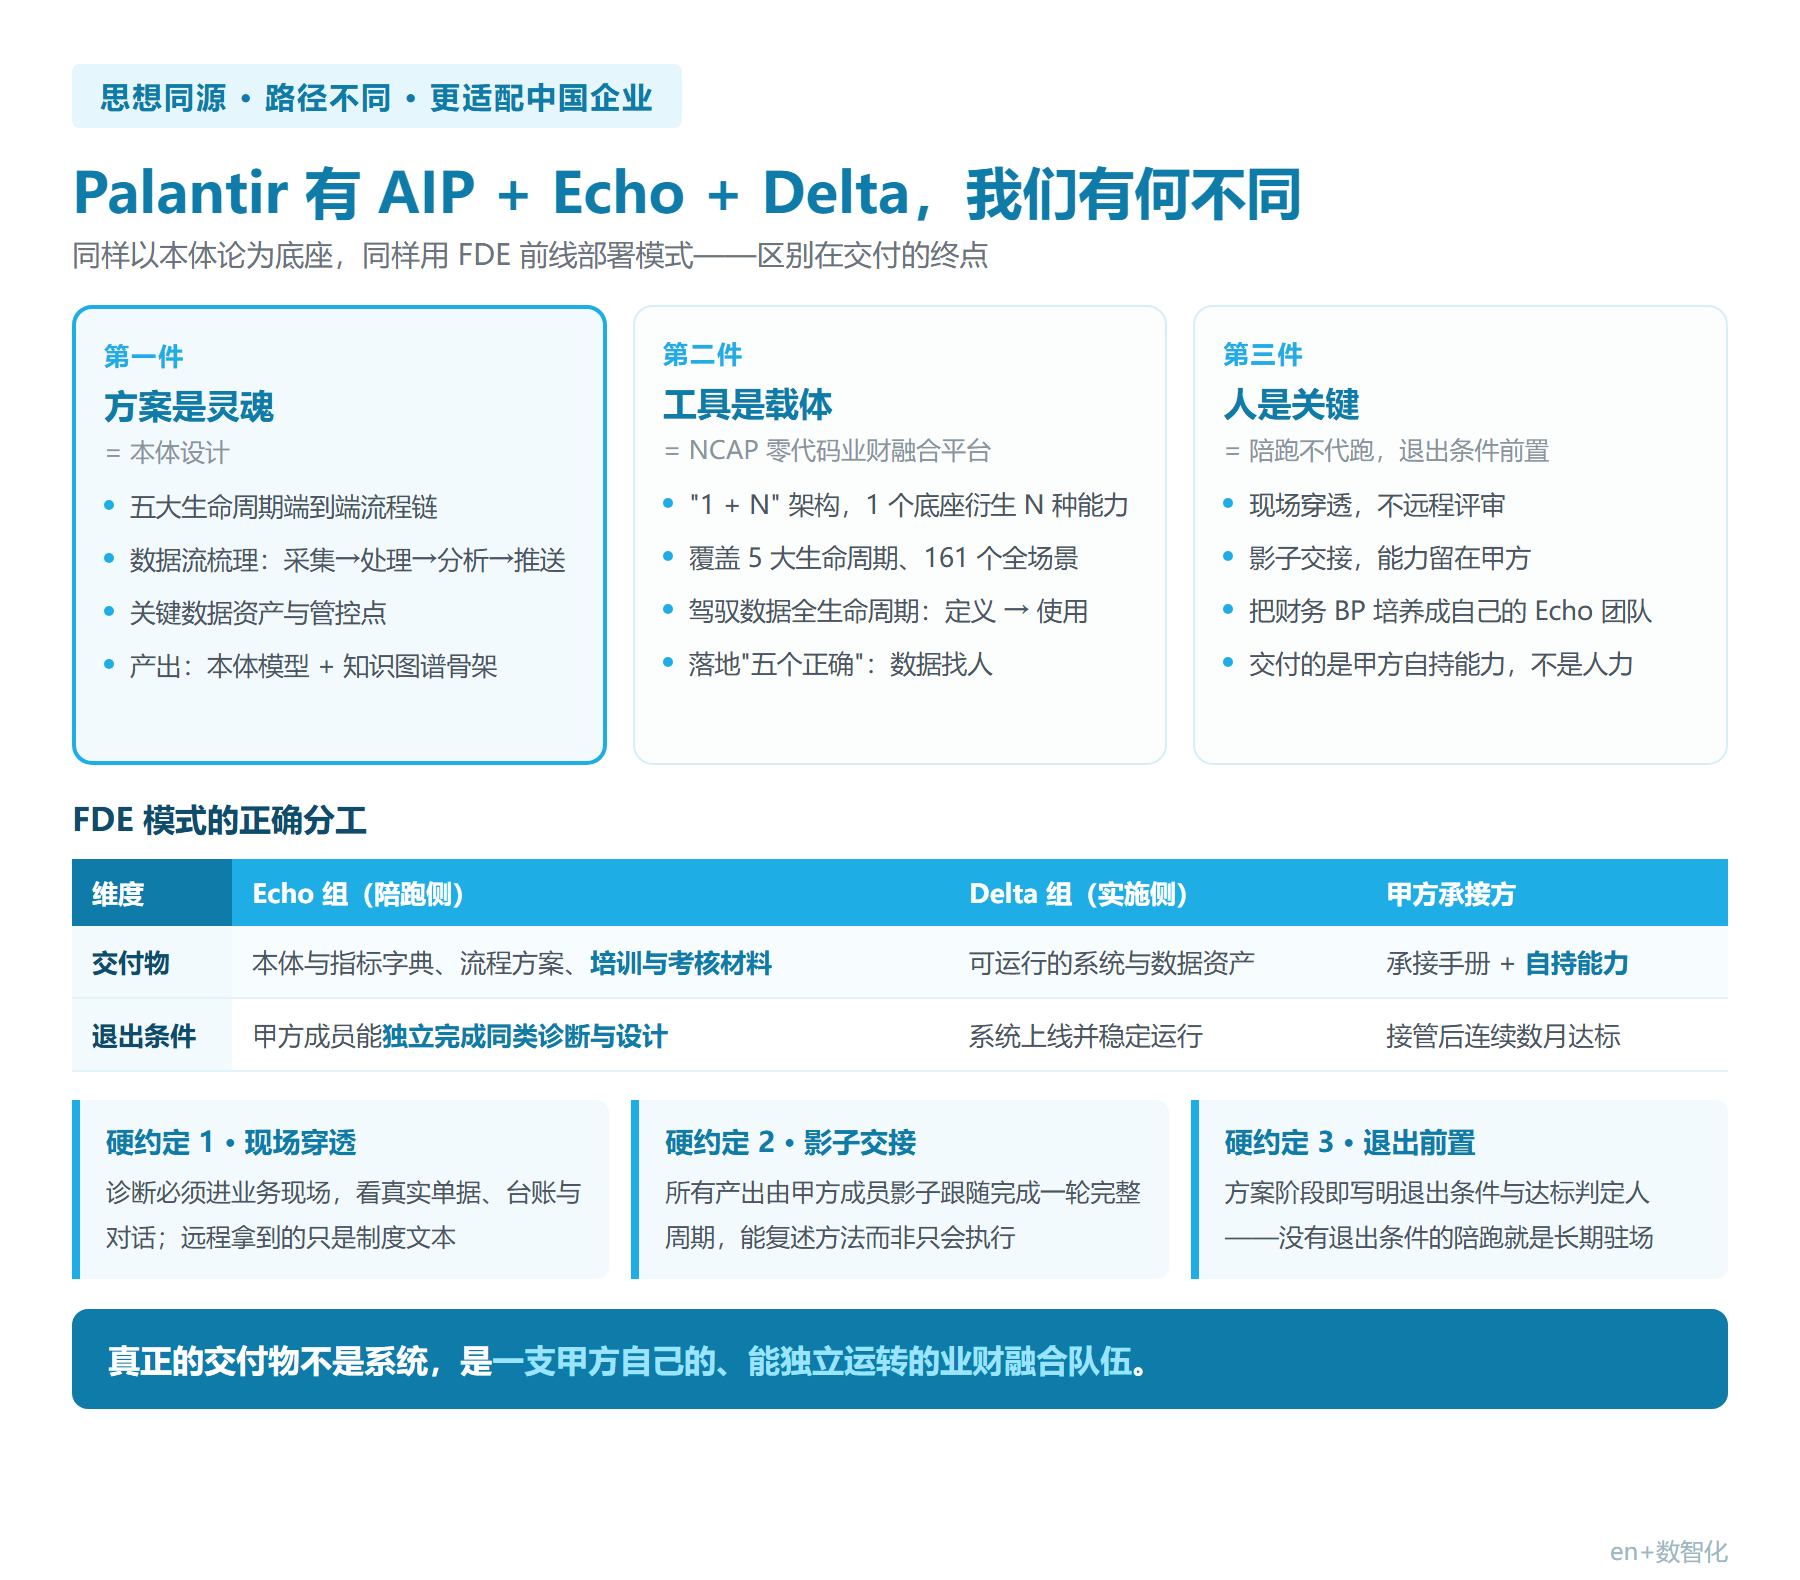
Palantir 用自己的 AIP 平台加 Echo、Delta 团队来承载;中国企业需要自己的路径,但思想同源。
这篇回答 6 个问题:
这两年 Palantir 被反复讨论,大多数人盯的是它的 AI、它的政府客户、它的股价。
但真正让它难以被复制的,是它产品里那一层叫 Ontology(本体) 的东西。
这一层干的事,说穿了特别朴素:
它不是回答“数据存在哪张表里”,而是回答“这个东西叫什么、它跟什么有关系、谁能对它做什么”。
举个特别常见的例子。
一家公司里的“客户”,通常躺在三张表里:销售系统的 crm_client、财务系统的 fi_customer、售后系统的 svc_account。
三张表,三个编码,三种含义。销售说“这个客户已经签了”,财务说“这个客户还没生效”,售后说“这个客户的账号已经开了”。
三个人说的都是真的,但谁也说服不了谁——因为他们说的根本不是同一个东西。
本体层要做的,就是把这三张表统一成一个客户,并且把话说死:
| 要回答的 | 说白了就是 |
|---|---|
| 它长什么样 | 等级、信用、账期、归属谁 |
| 它跟什么牵着 | 合同、订单、发货、回款、工单 |
| 能在它身上干什么 | 准入、变更、冻结、核销 |
| 干这些事有什么规矩 | 授信额度、账期上限、审批链 |
你可以把这层理解成公司的“普通话”——在此之前,每个部门说的都是方言。
AI 只能在这层“普通话”之上工作。
没有它,大模型面对的是几百张互不相认的表,它唯一能做的事就是猜。而猜出来的结论,业务方一句“你这口径不对”就能推翻。
这就是为什么很多企业买了大模型、做了问答机器人,最后都停在“演示很惊艳、业务不敢用”。
缺的不是模型,缺的是那本全公司都认的词典。
别被这个词吓住。放到你的公司里,它只问三个问题。
| 问题 | 你公司大概率的回答 |
|---|---|
| 你公司的“客户”,是一个客户吗? | 销售、财务、客服三套编码,三套含义 |
| 谁能在什么时候改它? | 说不清,反正好像都能改 |
| 它一改,会牵动谁? | 订单一变,各部门各自重算一遍 |
只要有一条答不上来,结论就一句话:
你公司有的只是表,没有“词典”。
好,问题来了:这本词典,谁来写?
很多人一听“业财融合”,第一反应是两种:
要么觉得“财务要来管业务了”;要么觉得“这是会计准则那一套,是给税务局和审计师看的”。
这两种理解都偏了。
先说清楚一件事:你公司那份财务报表,本来就不是给你做经营决策用的。
它是给谁看的?给税务、给审计、给投资人、给银行。它回答的是“外人怎么看我们”,所以必须遵循统一的会计准则,必须可比、可审计、可追责。
这套东西重要吗?重要。但它只是数据的一种用法。
而老板每天要回答的是另一类问题:
这些问题,财务报表回答不了。
会计这门学问,其实有三副眼镜:
| 眼镜 | 回答什么 | 给谁用 | 按什么切 |
|---|---|---|---|
| 财务会计 | 收入确认了吗、成本配比了吗 | 税务、审计、投资人 | 会计科目、期间、法人主体 |
| 管理会计 | 这个客户/产品/区域到底赚不赚钱 | 老板、业务负责人 | 客户、产品、区域、渠道、项目 |
| 经营分析 | 跟预算比、跟同期比,趋势对不对 | 一线管理者 | 时间、组织、责任人、预算口径、状态 |
业财融合真正的价值,在后两行。 前面那一行,只是其中一个维度。
顺带说一句扎心的:很多老板觉得财务报表“看不懂、用不上”——这不是你的问题,也不是财务的问题。那份表本来就不是给你做经营决策用的。 真正用于经营的那一套数字,得靠业财融合来建。
企业要把经营往下钻,钻到不能再钻,最后落在哪儿?
不是部门,不是会计科目,是一件一件具体发生的事:
这些“事”,才是数据第一次被产生的地方。
所以业财融合的顺序永远是:
先把事情发生时产生的那个最小颗粒度的数据定义清楚,再谈怎么用它(采集、处理、分析、推送)。
注意,这里说的定义不是技术定义(什么字段类型、多长、什么编码),是业务定义。
三句话,说的是同一件事的三个侧面。业财融合要做的,是把它们收敛成一个有明确判断条件的定义,并且指定谁对它负责。
一个数据要定义清楚,得填九件事:定义、使用、取值规则、分发规则、口径、维度、状态、约束条件、关联关系。
这九件事,就是“细致度”的尺子。 填不满,后面全是坑。
| 环节 | 要回答的问题 |
|---|---|
| 采集 | 这个数是在哪个动作上第一次产生的?谁产生的? |
| 处理 | 经过哪些口径、规则、分摊与归集?谁对它负责? |
| 分析 | 按哪些维度切?跟什么比?异常怎么识别?阈值多少? |
| 推送 | 最后给谁看?什么时候?通过什么渠道?触发什么动作? |
注意最后那一行——推送。
这是业财融合跟传统 BI 最大的区别:不是让人去翻,而是让数据主动找到人。这一点,第五节专门展开。
把上面四小节收成一句话:
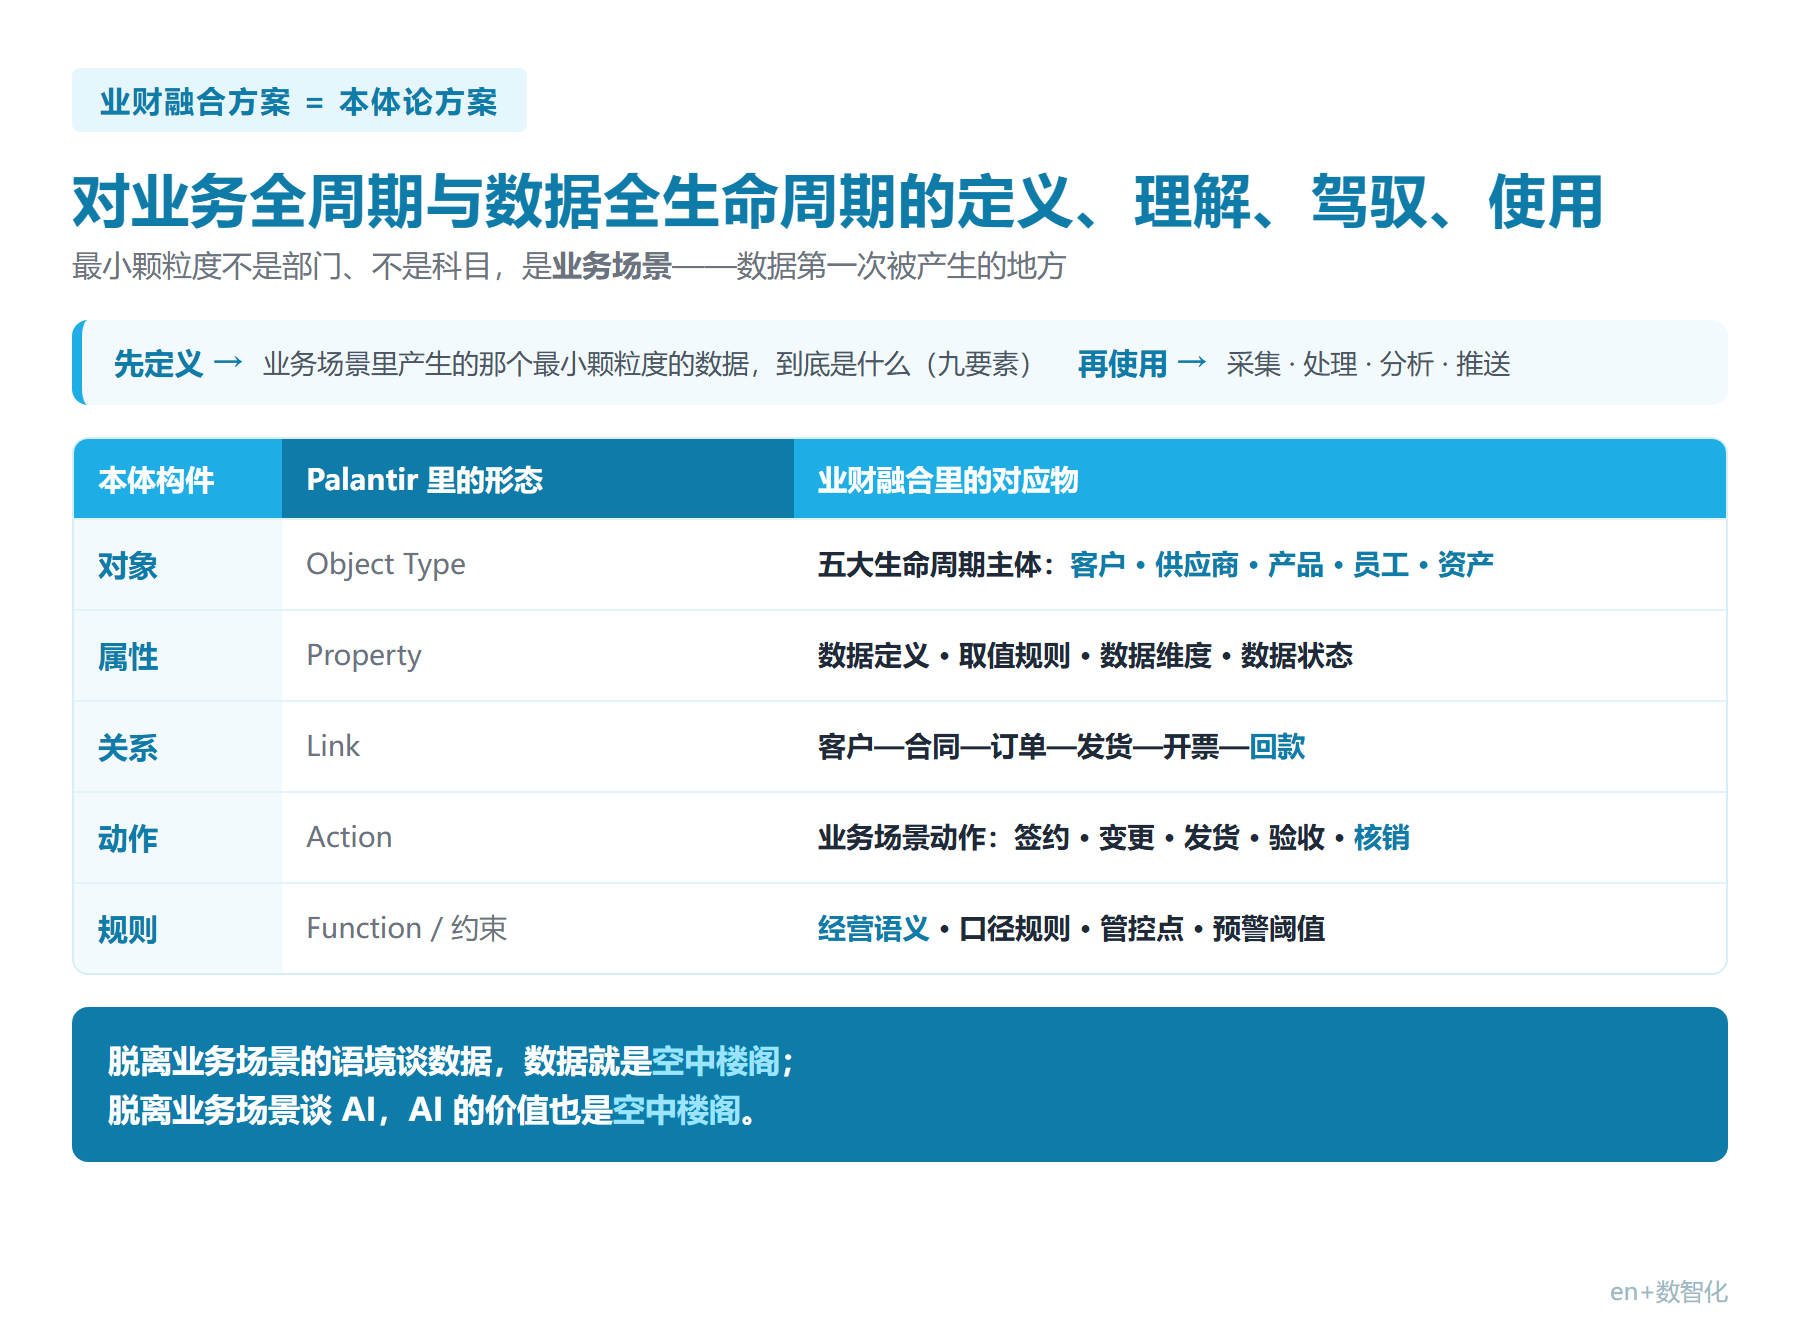
业财融合方案,就是对“业务全周期”和“数据全生命周期”的定义、理解、驾驭和使用。
Palantir 管这叫 Ontology,我们管这叫业财融合。
在企业落地的语境里,它们解决的是同一件事:让全公司说同一套话。
这是当下企业数智化最常见的内耗源头。
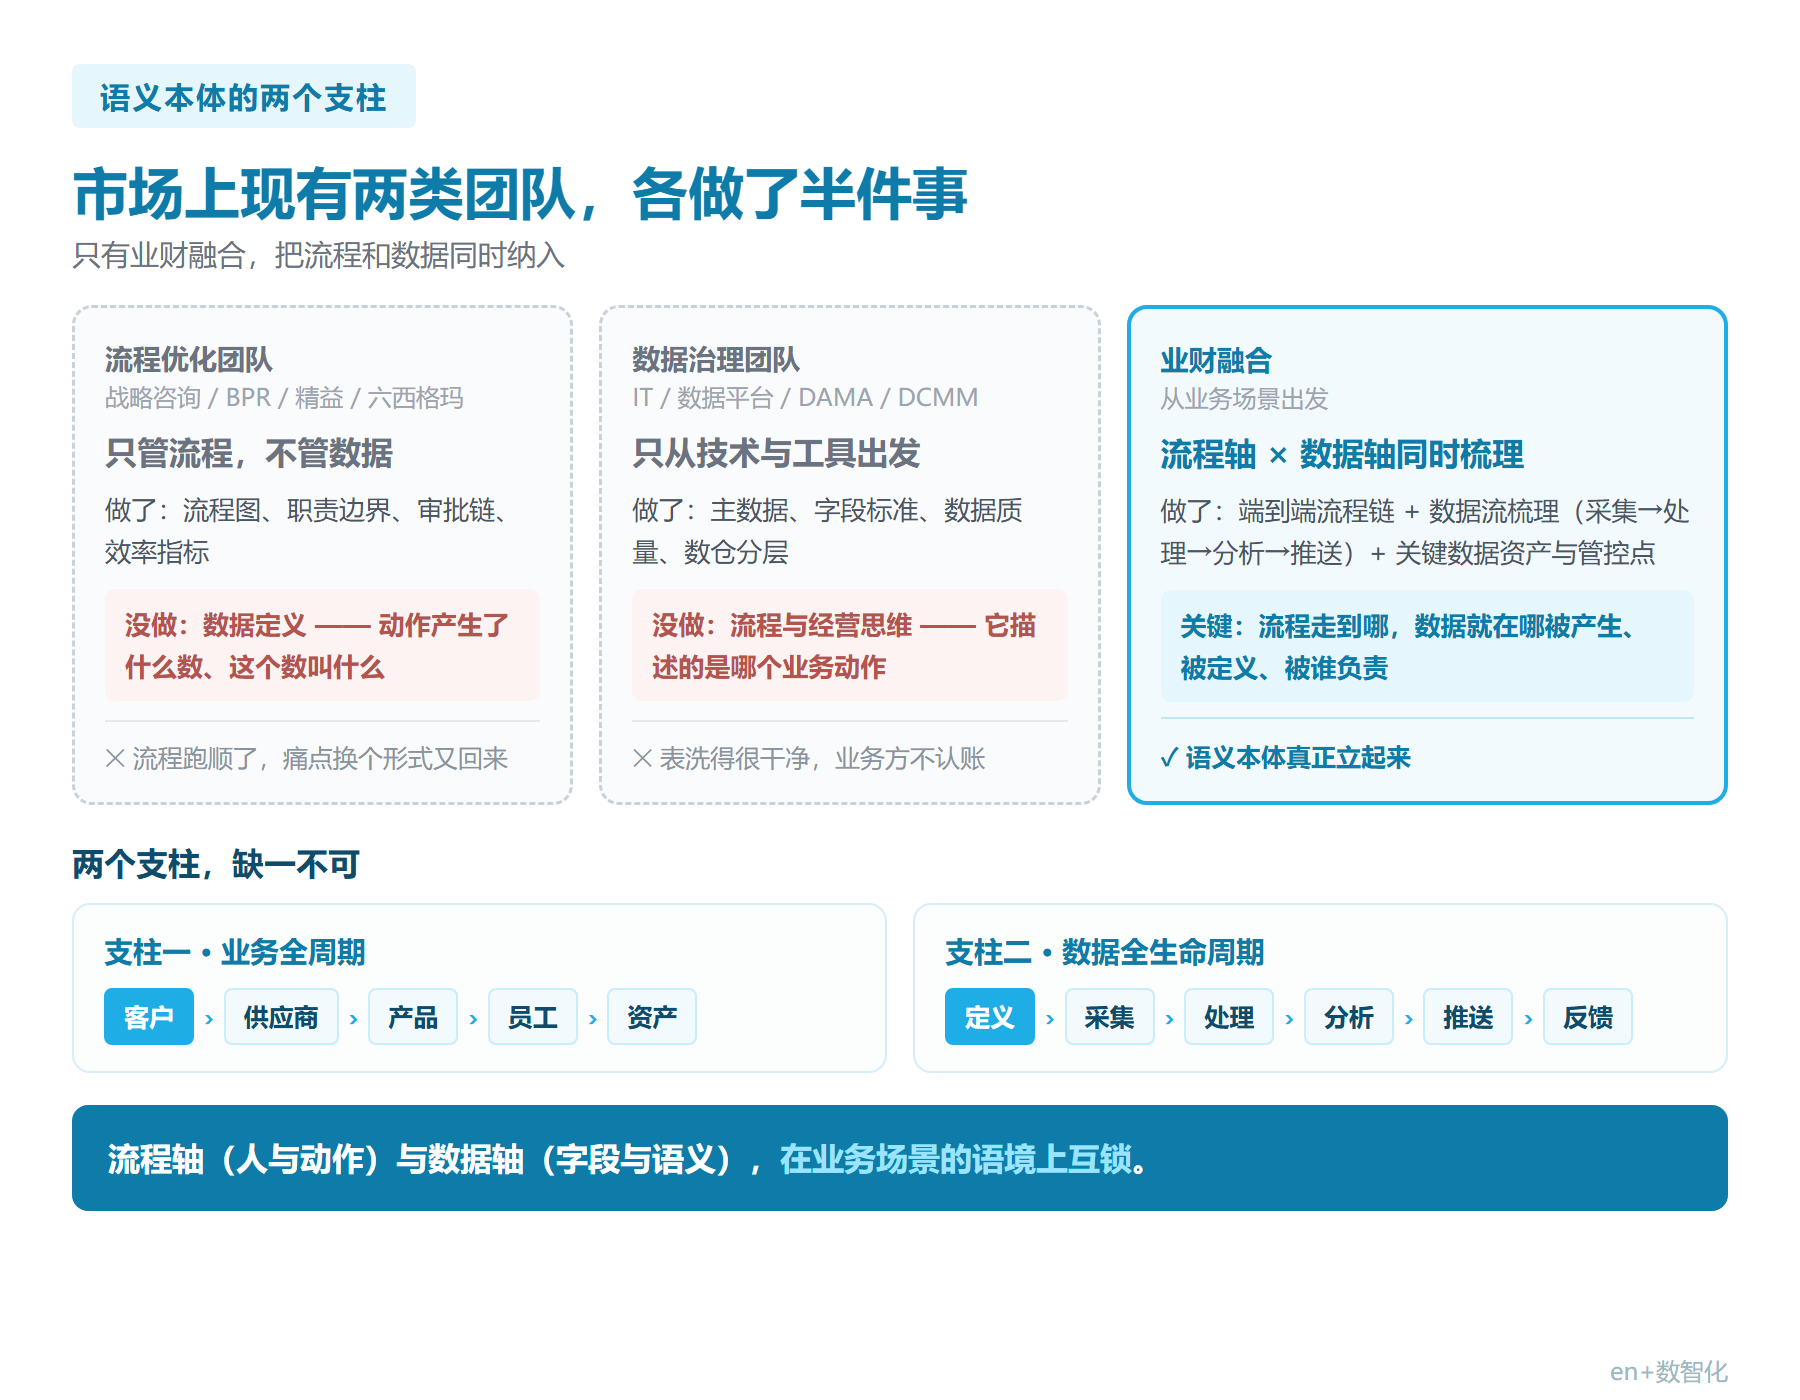
| 团队 | 出发点 | 做了 / 漏了什么 | 结果 |
|---|---|---|---|
| 流程优化团队 (战略咨询、BPR、精益、六西格玛) | 人和动作 | 做了流程图、职责边界、审批链、效率指标;漏了数据怎么定义 | 流程跑顺了,数据定义还是空的,痛点换个马甲又回来 |
| 数据治理团队 (IT、数据平台、DAMA、DCMM) | 技术和工具 | 做了主数据、字段标准、数据质量、数仓分层;漏了流程和经营 | 表和字段洗得挺干净,业务不认账,做完没人用 |
| 业财融合 | 一件件具体的事 | 流程和数据同时梳理,不漏 | “词典”才立得起来 |
前两类团队不是能力不行,是各自只做了一半:一个把动作管规范了,却没定义动作产生了什么数;另一个把字段洗干净了,却说不清它描述的是哪件事、结果谁负责。
这本“词典”需要两条腿,缺一条就站不住:
| 支柱 | 内容 |
|---|---|
| 第一条腿:业务全周期 | 客户、供应商、产品、员工、资产五大生命周期主线 |
| 第二条腿:数据全生命周期 | 定义 → 采集 → 处理 → 分析 → 推送 → 反馈 → 归档 |
两条腿必须咬在一起:
一句话:流程这条线(谁做了什么)和数据这条线(这个数叫什么),在一件件具体的事上锁死。
这就是为什么“业务场景和数据不分家”不是一句口号,而是方法论的前提:
脱离具体的业务场景谈数据,数据就是空中楼阁;脱离业务场景谈 AI,AI 的价值也是空中楼阁。
回到开头那个场景。老板要一个数,三个人翻四个系统、对两天口径,对出来还可能打架。
这不是个别现象,这是绝大多数企业的日常:
数据就在那儿,但它在等人来找;找到了,你还得自己判断它对不对、要不要紧、该谁负责。
en+数智化在做业财融合时,有一条黄金法则:
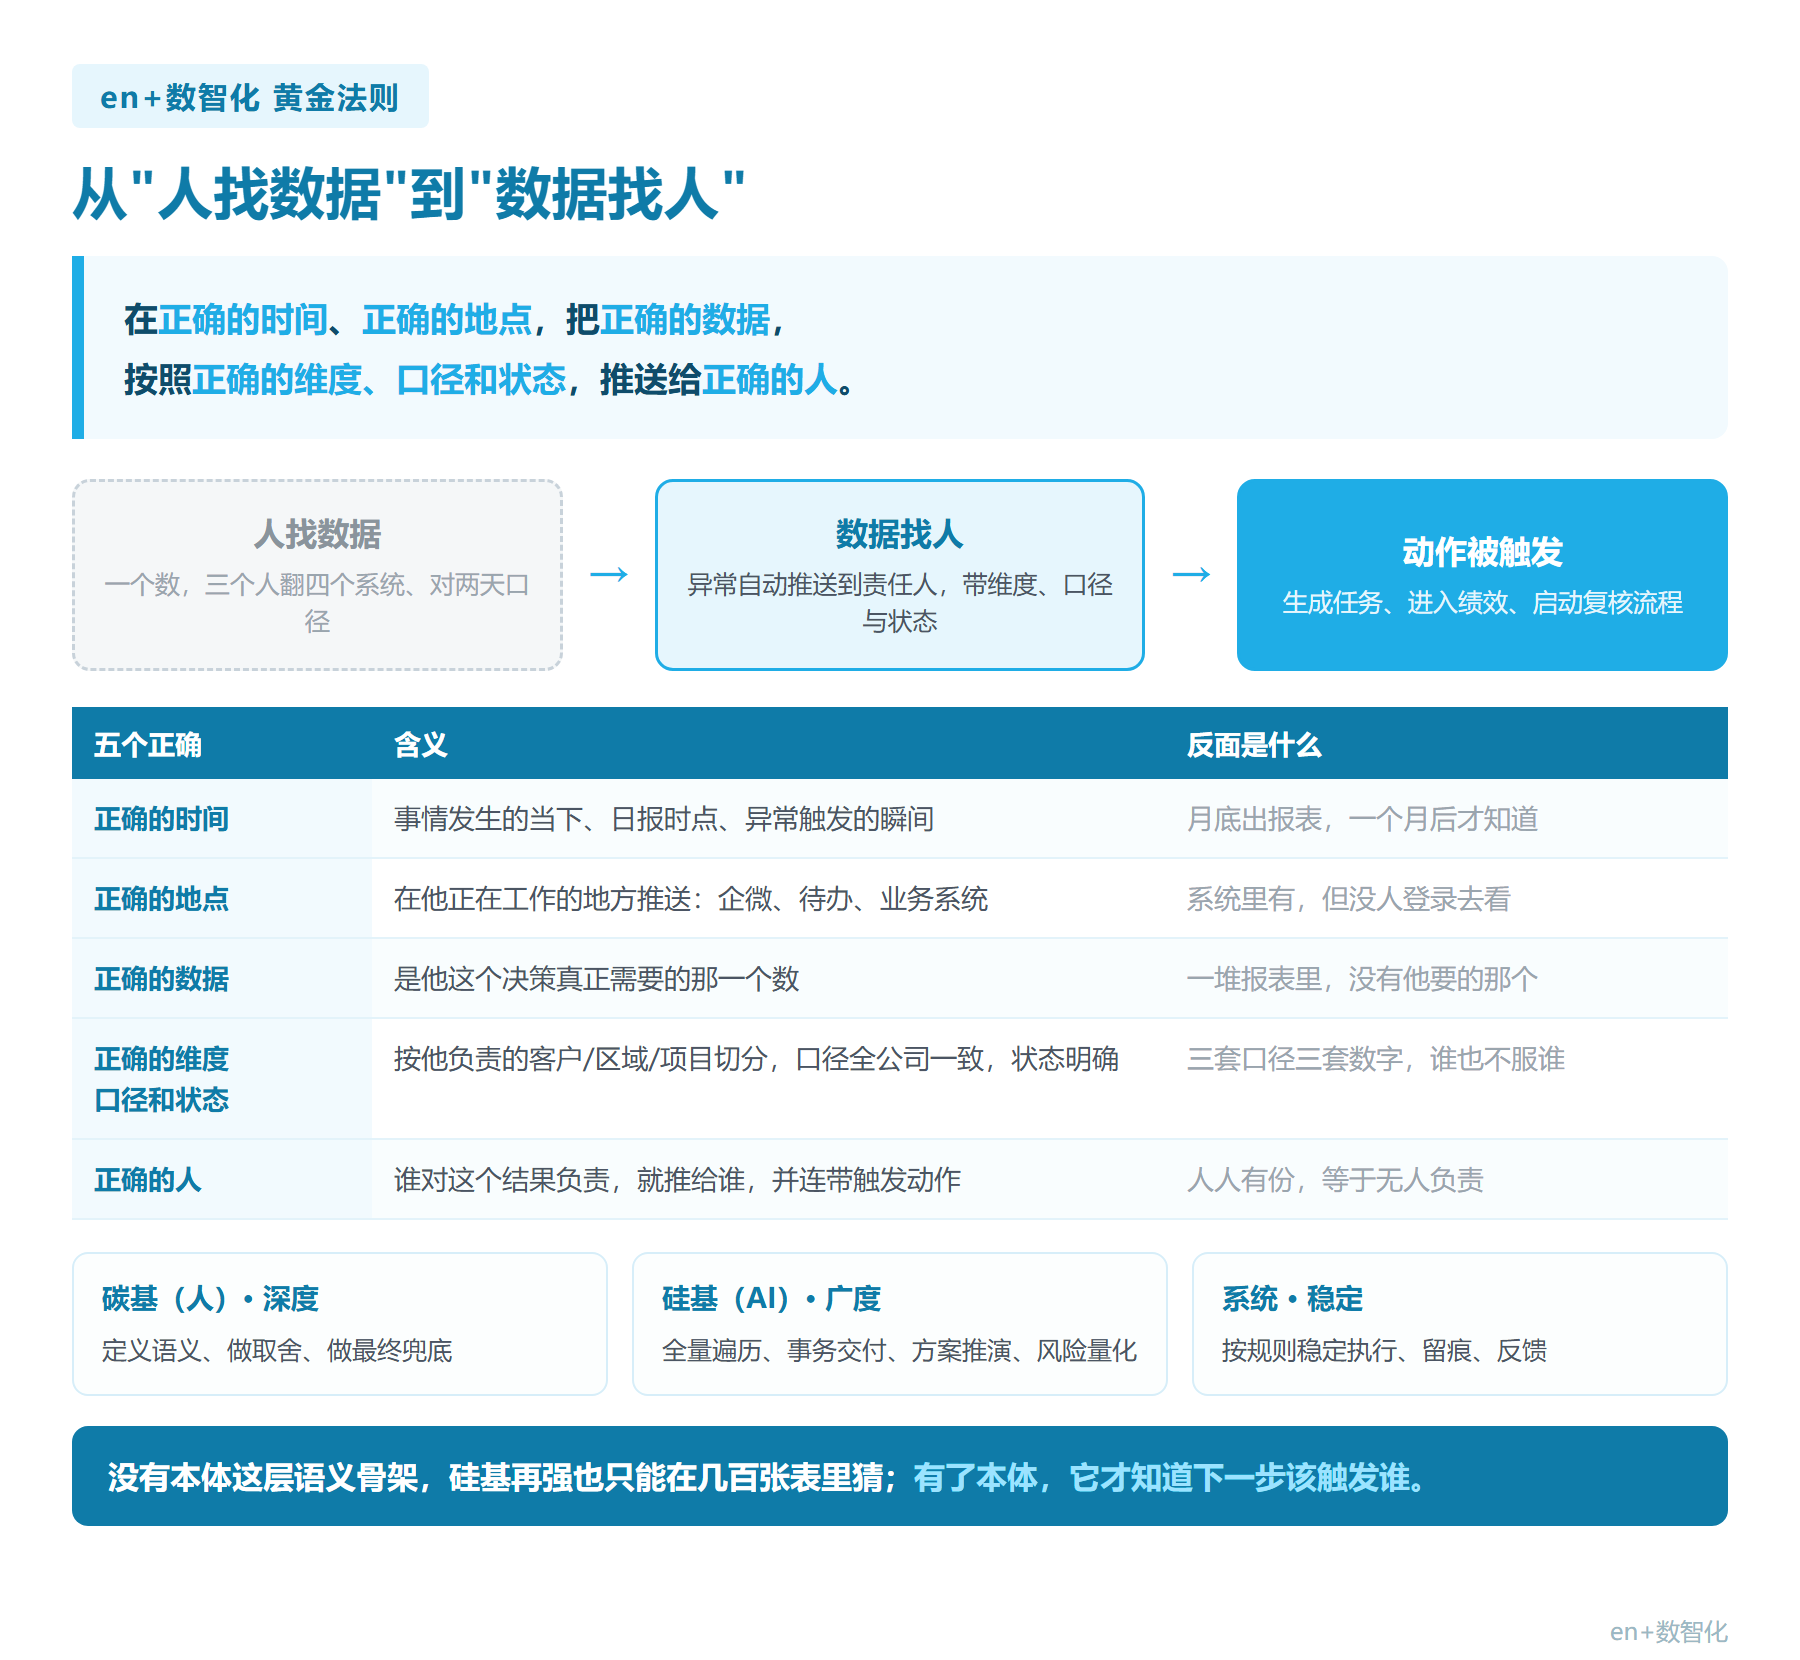
在正确的时间、正确的地点,把正确的数据,按照正确的维度、口径和状态,推送给正确的人。
五个“正确”,缺一个都不成立:
| 正确在哪儿 | 什么意思 | 不正确时什么样 |
|---|---|---|
| 正确的时间 | 事情发生的当下,而不是月底 | 月底出报表,一个月后才知道出问题了 |
| 正确的地点 | 在他正干活的地方推(企微、待办、业务系统) | 系统里有,但没人登录去看 |
| 正确的数据 | 是他这个决策真正需要的那一个数 | 一堆报表里,没有他要的那个 |
| 正确的维度、口径、状态 | 按他负责的客户/区域/项目切,全公司一个口径,状态清楚(新建/生效/变更/停用) | 三套口径三套数,谁也不服谁 |
| 正确的人 | 谁对这个结果负责,就推给谁 | 人人有份,等于无人负责 |
打个比方就是:从“你去图书馆翻书”,变成“书送到你桌上,还夹了张便签,写着你该干什么”。
| 场景 | 触发 | 推给谁 | 连带动作 |
|---|---|---|---|
| 一笔应收逾期 15 天 | 状态变了 + 触发阈值 | 客户经理,抄送财务 BP | 生成催收任务,计入绩效口径 |
| 某客户毛利率跌破阈值 | 同比异动 | 事业部负责人 | 触发定价复核流程 |
| 某供应商交付准时率下滑 | 指标异动 | 采购负责人 + 财务 BP | 触发供应商复评 |
到了这一步,数据才真正进入经营闭环——不是“看到了”,而是“有人必须动”。
这也正是 Palantir 一直推崇的那件事:在本体之上,AI 不只是“回答问题”,而是在对象上执行动作。
“词典”立起来之后,谁来用它?两种载体:
| 载体 | 特点 | 干什么 |
|---|---|---|
| 人(碳基) | 深度 | 定语义、做取舍、兜底 |
| AI(硅基) | 广度 | 全量遍历、方案推演、风险量化、自动执行 |
| 系统 | 稳定 | 按规则稳定执行、留痕、反馈 |
AI 和人,都是实现这套理念的载体,不是对手。
没有那本“词典”,AI 再强,也只能在几百张表里猜;有了它,AI 才知道“客户”指什么、“逾期”意味着什么、下一步该去找谁。
一句话收口:
从“人找数据”,到“数据找人”,再到“动作被触发”——这才是业财融合的最终形态。
这一节,专门写给做了十年、二十年财务的人。
智联招聘的应收部门,原来 21 个人,干的是每月 30 万笔客户回款的匹配与核销。
en+数智化从“回款匹配自动化”这一个点切进去,逐步迭代到基于回款的绩效考核与分配自动化,最后这个项目升级为智联招聘集团的收入数据中台——一个 CEO 级别的项目,成为整个集团处理和分发收入数据、绩效数据的核心平台。
结果:应收部门从 21 人降到 2 人(只处理异常),每年为智联招聘节省约 200 万元。
请注意这个演进路径:它不是“上个系统省几个人”,而是从一件具体的事里的数据断点出发,长出了一套“词典”,最后长成了集团的数据中枢。
这 19 个人干的活,本质上是:把数据从一个系统搬到另一个系统,按规则对上,对不上就人工判断。
这类活,系统比人快一万倍,而且不会累、不会错、不用加班。
所以被替代的不是“财务”,是“搬运”。
同时发生的还有另一件事:这家公司反而更需要懂业务、懂规则的财务了。
因为回款该归给谁、绩效该怎么算、异常怎么处理——这些规则不再由人去“对”,而是必须由人来定。
从“执行规则”到“定义规则”,这就是财务这个职业正在发生的事。
很多财务人都有过这种感觉:考了管理会计的证,学了一堆本量利、边际贡献、责任中心、差异分析,回到公司发现——用不上。
然后慢慢就放下了,继续做凭证、出报表、对账。
不是方法错了,是没有弹药。
你要算“这个客户到底赚不赚钱”,需要什么?需要把这个客户的收入、成本、费用、返工、售后、账期、资金占用,全部按同一个口径归到他身上。
现实是什么?
所以问题不在你——是这套方法,一直没赶上好时候。
最后只能退回核算——不是因为你只会核算,而是因为只有核算的数据是现成的。
管理会计那套方法,第一次有了落地条件:
| 过去卡在哪 | 现在怎么解 |
|---|---|
| 数据散在好几个系统里 | 按业务场景定义后,数据在全生命周期里被统一承载 |
| 口径不统一,算出来没人信 | 口径先被定义、被认定、被留痕 |
| 算一次要两周,决策早过了 | 规则固化在平台上,实时算、实时推 |
| 只能按月看,看不到过程 | 按状态、按阈值动态预警 |
多维、多口径、多状态的动态管理——这句话管理会计课本讲了三十年,一直缺一个能承载它的底座。
业财融合方案 + 零代码平台,就是这个底座。
所以不是管理会计过时了,是它的时代刚刚到。
这几年“财务 BP”岗位大量涌现,很多财务人以为这是个新东西。
不是。
财务 BP = 管理会计 + 业务现场 + 数据能力。
它做的事,就是把课本里那些方法,落到一件件具体的事上:
一句话:
财务 BP 不应该只是“懂业务的财务”,而应该是“企业词典的现场编写者”。
它靠三样东西:
| 组成 | 角色 | 干什么 |
|---|---|---|
| AIP / Foundry 平台 | 载体 | 承载本体模型,让语义可运行、可被 AI 调用 |
| Echo 团队 | 方案侧 | 扎到业务现场,做语义定义、口径收敛、流程重塑 |
| Delta 团队 | 工程侧 | 系统实现、数据管道、集成与上线 |
这套打法有个专门的名字:FDE(Forward Deployed Engineer,前线部署工程师)——不坐在办公室里写方案,而是扎到业务现场,看真实的单据、真实的台账、真实的对话,从现场里长出方案来。
FDE 这几年在全球迅速扩散:Palantir 是源头,OpenAI、Anthropic 等公司也陆续组建了类似团队。
原因很简单:企业级 AI 落地的瓶颈从来不是模型能力,而是“没人能把业务语义讲清楚并固化下来”。
| 全球 FDE 的本意 | 国内常见的走样形态 |
|---|---|
| 现场穿透,从现场长出方案 | 远程评审,交付制度文本 |
| 培养甲方自己的人 | 驻场人力外包,按人月计费 |
| 能力交接、有退出条件 | 越做越离不开,长期驻场 |
| 交付语义资产(词典、口径、规则) | 交付一堆报表和看板 |
走样的结果是:项目结束之日,就是能力归零之时。
顾问一撤,口径又开始打架,系统没人敢改。
这不是 FDE 错了,是“陪跑”被做成了“代跑”。
这里必须先说清楚一件事:我们不敢说、也没必要说自己是“中国版 Palantir”。
准确的表述是:思想同源,路径不同,更适配中国企业。
Palantir 面对的是欧美企业已经高度标准化、主数据相对成熟的环境。而中国大量企业面对的是:ERP 好几套并存、基础编码不统一、业务变化快,而且真正懂经营语义的人,往往在财务和业务骨干身上,不在 IT 部门。
路径必须不同。我们的做法是把这件事拆成三件:
第一件:方案是灵魂 —— 业财融合方案,就是“词典”的设计
按客户、供应商、产品、员工、资产五大生命周期,做端到端的三段式梳理:
这套方案本身就是企业的本体模型与知识图谱骨架,它不依赖任何软件而存在。
第二件:工具是载体 —— NCAP 零代码业财融合平台
方案写得再好,不能被承载、被执行、被迭代,就只是一份 PPT。
en+数智化自研的 NCAP 平台,采用“1 + N”架构——1 个数智化底座,衍生 N 种能力与行业解决方案,覆盖客户、供应商、产品、员工、固定资产五大生命周期、161 个全场景。
它的价值在于:能驾驭数据的全生命周期——从数据定义,到数据使用(采集、处理、分析、推送),都在同一个底座上完成,并且始终受业财融合方案的指引与约束。
更关键的是,它把第四节那五个“正确”变成了现实:在正确的时间、正确的地点,把正确的数据,按照正确的维度、口径和状态,推送给正确的人。
这就是它与 Palantir AIP 在思想上高度一致的地方:先定义语义,再约束数据;平台承载“词典”,而不是承载表格。
区别在于,NCAP 是零代码的——这让甲方自己的财务 BP 和业务骨干能参与迭代,而不是每次改一个口径都要回 IT 排期。这一点,对中国企业尤其关键。
第三件:人是关键 —— 陪跑不代跑,退出条件前置
这是我们与“驻场外包”最本质的区别。
| 维度 | 陪跑组(Echo 侧) | 实施组(Delta 侧) | 甲方承接方 |
|---|---|---|---|
| 定位 | 业务侧穿透 + 能力定义与陪跑 | 系统实现与集成 | 自主运营 |
| 核心职责 | 现场诊断、语义与口径定义、流程重塑、带教 | 平台配置、数据接入、上线运维 | 日常运营与迭代 |
| 交付物 | 本体与指标字典、流程方案、培训与考核材料 | 可运行的系统与数据资产 | 承接手册 + 自持能力 |
| 退出条件 | 甲方成员能独立完成同类诊断与设计 | 系统上线并稳定运行 | 接管后连续数月达标 |
三条硬约定:
我们真正的交付物不是系统,是一支甲方自己的、能独立运转的业财融合队伍。
前面提到的智联招聘,走的正是这条路。
我不想把业财融合说成万能药。以我的经验,下面四个前提只要有一个不成立,项目大概率会失败,不如先别动。
| 前提 | 不成立会怎样 | 建议 |
|---|---|---|
| 业务方必须真正在场 | 流程线和数据线没人认领,方案变成财务独角戏 | 先补齐业务方参与机制,再启动 |
| 必须有人能对“口径”做最终认定 | 同名不同义永远收敛不了,“词典”变成长久的争论 | 先明确口径的认定责任角色与升级路径 |
| 不能做成“核算项目” | 如果立项书里的主语全是会计科目、凭证、报表,方向就错了 | 立项书里必须出现客户、产品、区域、责任人这些经营维度 |
| 不能有“替我做决策”的期待 | 期望落空,项目被判定失败 | 它提供一致的事实与约束,取舍仍由人定 |
还得说清楚业财融合做不到什么:
我看到太多企业把顺序搞反了:先买平台,再想方案。结果是平台上线,说法照样混乱。
正确的顺序永远是:先有“词典”,再有平台;先有方案,再有工具。
| 优先级 | 动作 | 验收标准 |
|---|---|---|
| 高 | 把业财融合从“财务部门的项目”,升级为“经营决策层直接挂帅的企业级工程” | 立项文件里责任人是经营决策层,不是财务部 |
| 高 | 要求任何数据平台项目,必须先交付语义定义,再谈系统上线 | 项目里程碑里出现“语义/口径定义”节点 |
| 中 | 在预算里单列“能力建设”,而不是全部计进软件采购 | 甲方承接团队的培养计划被写进合同 |
| 优先级 | 动作 | 验收标准 |
|---|---|---|
| 高 | 定位从“出报表”转向“定语义”,把九件事填到五大对象的最小颗粒度场景上 | 客户/供应商/产品/员工/资产各有九要素完备度矩阵 |
| 高 | 补上管理会计与经营分析视角:同一件事,多维度、多口径、多状态 | 关键经营指标同时具备财务口径、管理口径、分析口径 |
| 中 | 建立口径认定机制:谁提、谁认、谁改、怎么留痕 | 有运行的口径评审流程与变更记录 |
| 中 | 给团队留一条向上的路:把做核算的人往 BP 上转 | 团队里有人能独立画出一条端到端流程链及其数据流 |
| 优先级 | 动作 | 验收标准 |
|---|---|---|
| 高 | 从“分析师”转型为“业务现场里的语义工程师” | 能独立画出一条端到端流程链及其数据流 |
| 高 | 按五个“正确”设计推送:时间、地点、数据、维度口径状态、责任人 | 关键异常能做到“数据找人”并触发动作 |
| 中 | 主动接手方案迭代,而不是等外部顾问 | 顾问撤出后口径治理机制仍稳定运转 |
问:业财融合,是不是就是让财务来管业务?
答:不是。业财融合不是权力归属的调整,是定义权的归位——把“签单”“交付”“回款”这些事产生的数,在全公司统一成一个定义,并指定谁对它负责。业务该怎么跑还是业务定,只是从今往后,大家说的是同一套话。
问:业财融合和我们一直在做的财务核算、对外报表是什么关系?
答:财务会计(对外披露、审计、合规)只是数据使用的一个维度,不是全部。业财融合真正站的是管理会计视角和经营分析视角——同一个经营事实,按客户、产品、区域、责任人多维切分,多口径、多状态地做动态管理、分析和预警。
问:能不能先买个数据平台,方案慢慢补?
答:顺序反了,大概率失败。正确的顺序永远是:先有“词典”,再有平台;先有方案,再有工具。 方案不成,平台就是个空壳——系统上线,说法照样混乱。
问:财务 BP 和管理会计是一回事吗?
答:管理会计是方法,财务 BP 是这套方法落地的岗位形态。财务 BP = 管理会计 + 业务现场 + 数据能力。 它不是新名词,是管理会计换了战场——从办公室的报表,换到业务现场的定义、预警和决策支持。
如果这篇你只记住一件事,希望是这句:
业财融合不是财务部门的内部工程,它是给企业统一说法的工程。
它把业务全周期和数据全周期同时纳入,让数据在正确的事里被定义、被使用、被推送——Palantir 管这叫本体论,我们管这叫业财融合。
决定投入之前,先用这四条给自己做个体检:
四条里只要有一条答不上来,说明这本“词典”还缺一块。
补上这一块,AI 才用得起来,数据才治理得动,经营决策才有同一个事实基础。
en+数智化 的做法是:咨询陪跑(方案是灵魂)+ NCAP 零代码业财融合平台(工具是载体)+ 甲方财务 BP 能力建设(人是关键),三位一体,退出条件前置写进方案——交付的不是驻场人力,是甲方自持的能力。
如果你的企业正卡在“数据很多、决策很难”这一步,欢迎聊聊。
企业级 AI 应用失败,90% 不是因为模型不行,而是因为企业还没把「数据到底代表什么」说清楚。